가상 스레드와 코틀린 코루틴의 사용법과 내부 구현은 이미 많이 소개되어 있습니다.
이 글은 두 기술을 각각 설명하기보다, 중단을 구현하는 방식의 차이에 따라 코드 작성과 운영이 어떻게 달라지는지를 비교합니다.
또한 가상 스레드를 도입했거나 검토 중인 JVM 서버 개발자를 대상으로, 가상 스레드에서 코드에는 보이지 않는 대가가 실행 중 어디에서 드러나는지를 중심으로 정리합니다.
요청당 스레드 하나를 배정하는 서버에서는 생성된 스레드 수가 곧 동시 처리 한계입니다.
크기가 200인 풀(Pool)이라면 201번째 요청은 200개 중 하나가 끝날 때까지 대기합니다.
그런데 그 200개 중 상당수는 실제로 연산을 수행하고 있지 않습니다.
DB나 외부 API의 응답을 기다리며 정지해 있을 뿐입니다.
아무 일도 하지 않는 동안 비싼 자원이 묶여 있다는 점은 작지 않은 문제가 됩니다.
이 문제에 대한 해결 방법은 사실 간단합니다. 대기하는 동안 OS 스레드를 반환하면 됩니다.
다만 이를 직접 구현하려면 코드 구조를 변경해야 합니다.
기다리는 지점에서 함수를 일단 종료하고, 결과가 온 뒤에 할 일은 별도의 콜백으로 분리해야 합니다.
리액티브 체인도 같은 이유로 생겨납니다.
그런데 이렇게 분해된 코드는 동작이 정확하더라도 읽고 수정하기 어렵습니다.
그래서 조건이 하나 붙습니다. 스레드는 반환하되 코드는 여전히 위에서 아래로 읽혀야 한다는 것입니다.
가상 스레드(Virtual Thread)와 코틀린 코루틴(Kotlin Coroutine)은 모두 이 문제를 해결하기 위해 고안되었습니다.
다만 두 기술의 구현 방식은 서로 다릅니다.
우선 두 기술은 모두 같은 절차를 거칩니다.
실행을 잠시 중단하고 스레드를 반환했다가, 대기가 끝나면 중단 지점에서 이어갑니다.
다른 점은 중단 상태를 보관하는 방식입니다.
가상 스레드는 스택을 저장한 뒤 복원하고(stackful), 코루틴은 함수에서 리턴한 뒤 그 함수를 다시 호출합니다(stackless).
가상 스레드는 런타임이 이 일을 담당하고, 코루틴은 컴파일러가 코드를 변환해 처리합니다.
이 방식의 차이로 코드에도 차이가 생깁니다. 즉, 가상 스레드는 중단 지점을 코드에서 숨기고, 코루틴은 코드에 표시합니다.
숨긴다고 해도 사라진다는 뜻은 아닙니다. 두 방식 모두 대기 비용을 낮출 뿐 자원의 총량을 늘리지 않습니다.
자원의 병목은 소멸하지 않고 덜 드러나는 위치로 이동할 뿐이며, 가상 스레드에서는 코루틴에서와 달리 그 위치가 코드에 나타나지 않습니다.
1. 중단의 구조 - 스택 저장과 함수 재호출
가상 스레드 - 스택 저장과 운반자 분리
Java 21에서 정식 기능이 된 가상 스레드의 특징은 코드에 표식이 없다는 점입니다.
아래 두 코드에서 비즈니스 로직에 해당하는 코드는 완전히 동일하고, executor를 생성하는 코드만 다릅니다.
// 기존: 요청당 OS 스레드 — 200개에서 막힌다
try (var executor = Executors.newFixedThreadPool(200)) {
    for (int i = 0; i < 10_000; i++) {
        executor.submit(() -> {
            String data = fetchFromDb(); // 스레드가 여기서 정지한다
            process(data);
        });
    }
}

// 가상 스레드: 로직은 그대로, 1만 개를 각각 가상 스레드에서 실행한다
try (var executor = Executors.newVirtualThreadPerTaskExecutor()) {
    for (int i = 0; i < 10_000; i++) {
        executor.submit(() -> {
            String data = fetchFromDb(); // 위와 완전히 동일한 코드
            process(data);
        });
    }
}
fetchFromDb()가 응답을 기다리는 동안 무엇이 발생하는지를 도식화하면 아래와 같습니다.
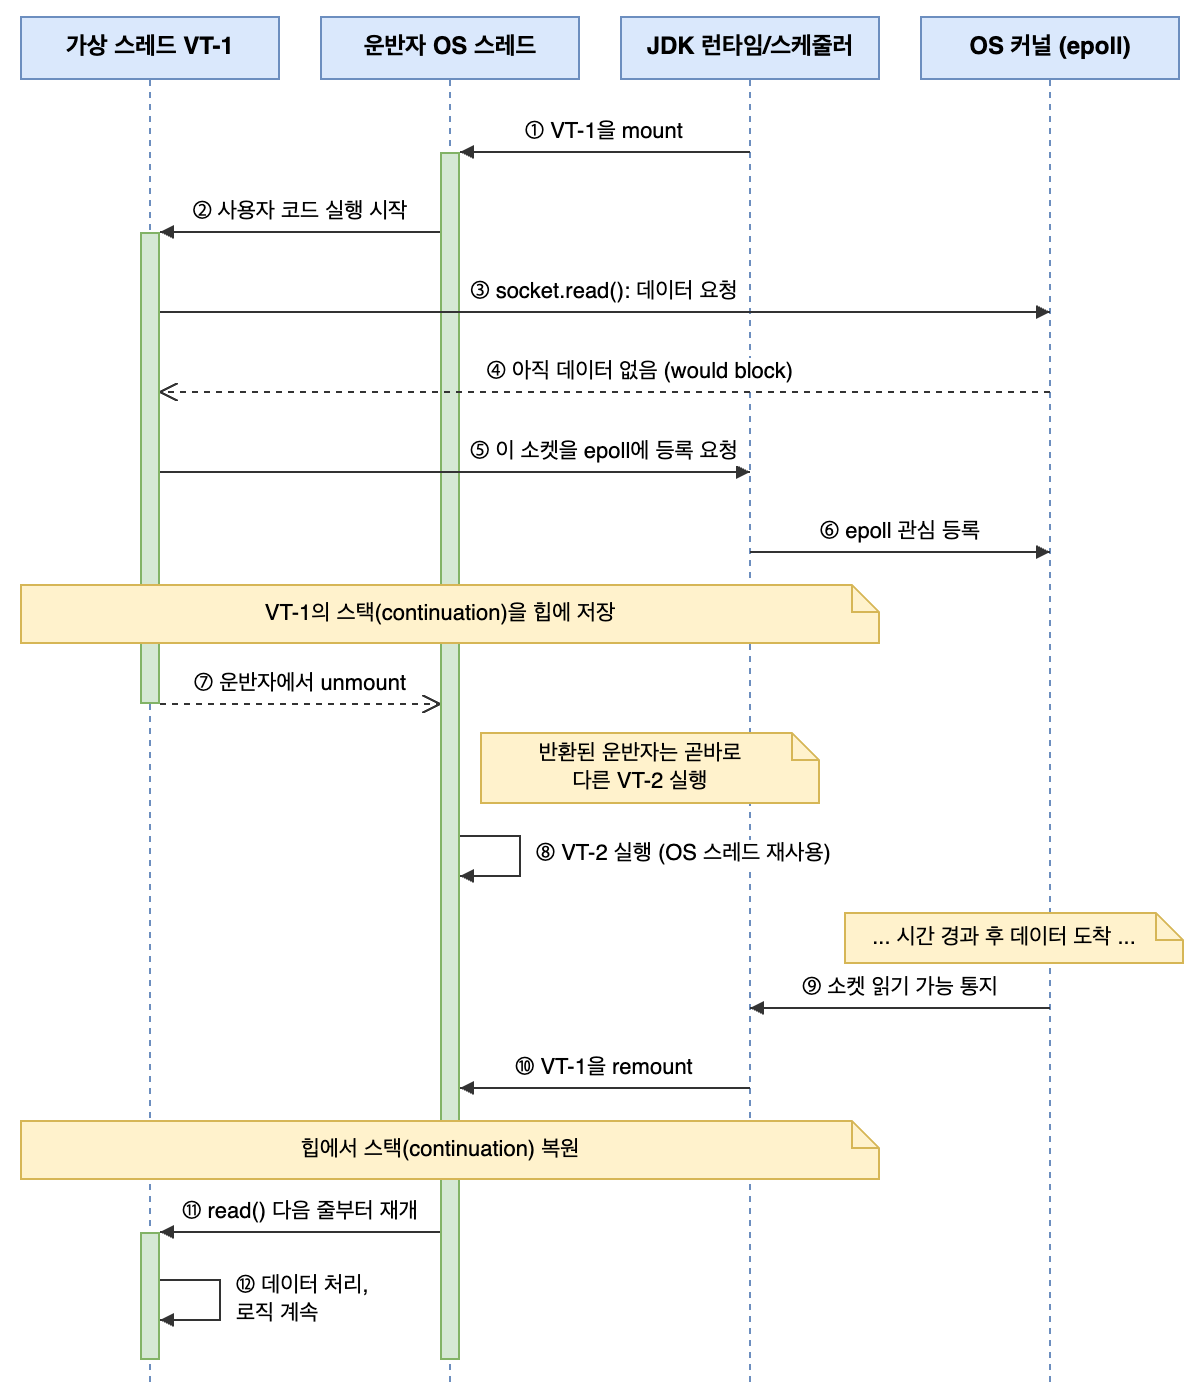
가상 스레드 VT-1은 운반자(carrier, 가상 스레드를 실제 실행하는 OS 스레드)에 mount되어(①) 사용자 코드를 실행합니다(②).
소켓에서 데이터를 요청했는데(③) 아직 도착하지 않았다면(④), 런타임은 그 소켓을 커널의 epoll에 등록해 두고 VT-1의 실제 스택 전체를 힙에 저장한 뒤 VT-1을 운반자에서 unmount합니다(⑤~⑦).
반환된 운반자는 곧바로 다른 가상 스레드 VT-2를 실행합니다(⑧).
커널이 읽기 가능을 통지하면(⑨) 런타임은 VT-1을 remount하고(⑩), 힙에서 스택을 복원해 read() 다음 줄부터 이어갑니다(⑪, ⑫).
⑦과 ⑪ 사이 구간에서 read()는 끝까지 리턴하지 않습니다. 호출 스택은 그대로 유지되고, 다만 OS 스레드에서 잠시 내려와 있을 뿐입니다.
운반자의 활성화 막대는 ①부터 끝까지 끊기지 않는 반면 VT-1의 막대는 ⑦에서 끊겼다가 ⑪에서 재개됩니다.
대기하는 주체가 값비싼 OS 스레드에서 값싼 가상 스레드로 교체되었다는 것이 이 다이어그램의 요점입니다.
| 구분 | 운반자 (= 플랫폼 스레드) | 가상 스레드 |
| 실체 | OS 스레드 | JVM 힙 위의 객체 |
| 개수 | CPU 코어 수 | 수십만 ~ 수백만 개 |
| 스택 | 고정 크기 (약 1MB) | 힙에 저장, 사용한 만큼 |
| 생성/전환 비용 | 높음 | 매우 낮음 |
코루틴 - 함수 리턴과 Continuation 잔존
코루틴은 중단 지점을 소스 코드에 명시합니다.
중단 가능한 함수에는 suspend를 명시해야 하고, suspend 함수는 다른 suspend 함수나 코루틴 빌더 안에서만 호출할 수 있습니다.
// 'suspend', 'launch' 같은 표식을 붙여야 한다
suspend fun handleRequest() {
    val data = fetchFromDb()        // 이 함수도 suspend여야 한다
    process(data)
}

runBlocking {
    repeat(10_000) { launch { handleRequest() } }
}
코루틴의 동작 방식을 도식화하면 아래와 같습니다.
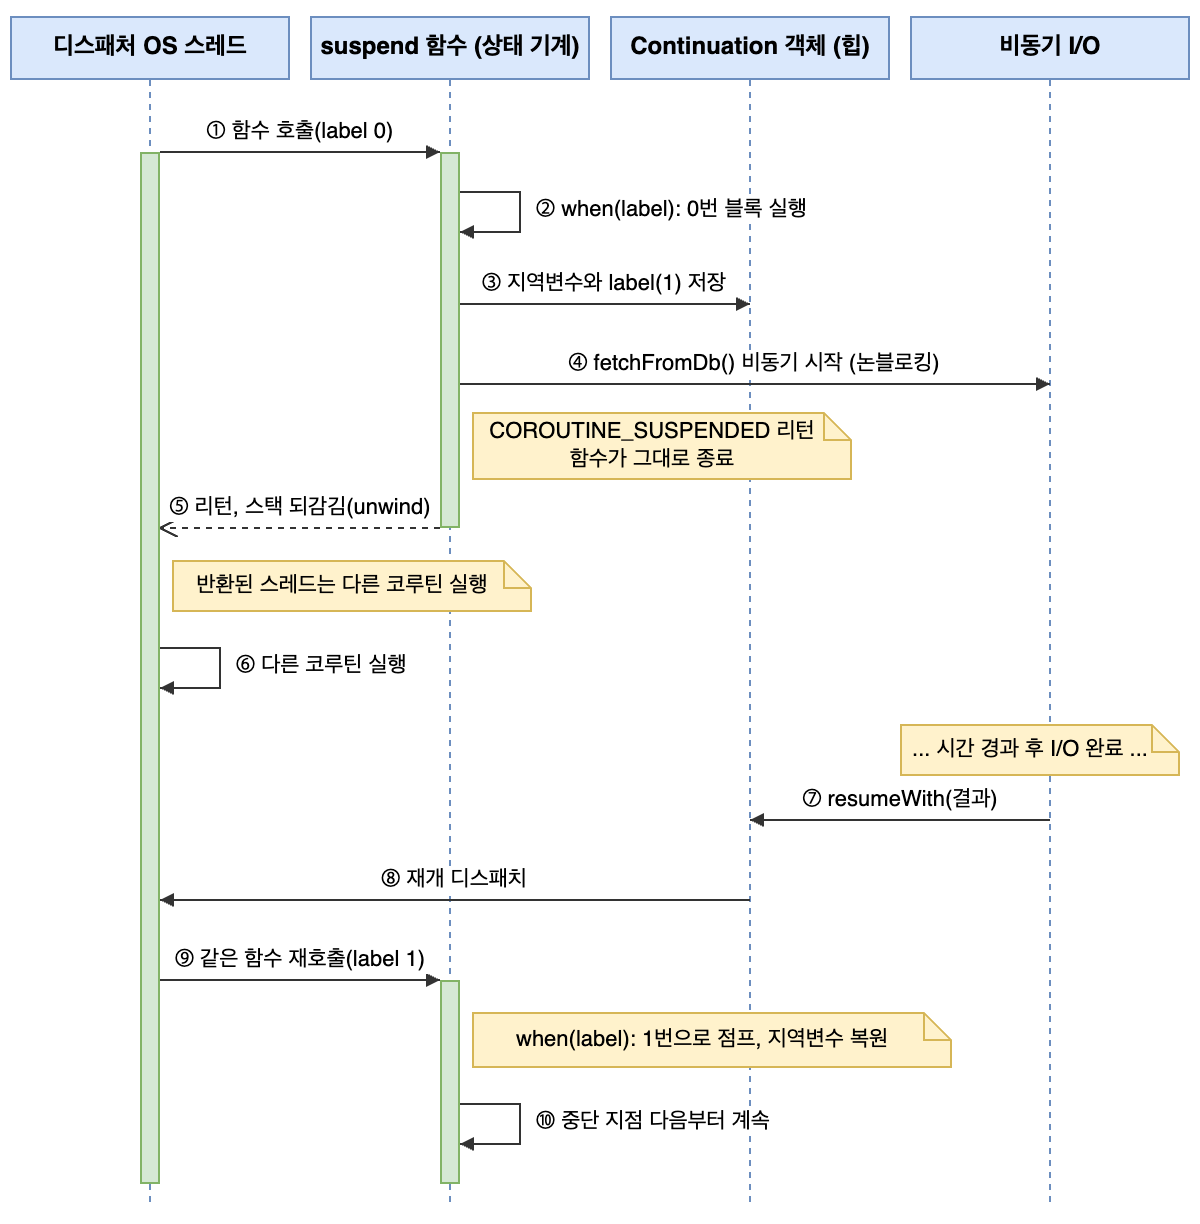
디스패처 스레드가 함수를 호출하면 label 0 블록부터 실행됩니다(①②).
중단 지점에 도달하면 지역변수와 다음 label 값을 힙의 Continuation 객체에 저장한 뒤(③), 비동기 I/O를 시작합니다(④).
그런 다음 함수는 COROUTINE_SUSPENDED를 리턴하며 실제로 함수가 종료됩니다(⑤).
스택이 되감기고, 반환된 디스패처 스레드는 다른 코루틴을 실행합니다(⑥).
I/O가 종료되면 resumeWith()로 결과가 전달되고(⑦) 재개가 디스패치되어(⑧) 같은 함수가 처음부터 다시 호출됩니다(⑨).
이번에는 저장된 label 1로 점프해 지역변수를 복원하고 중단 지점 다음부터 이어갑니다(⑩).
여기서 디스패처는 앞서 설명한 운반자에 대응하는 개념입니다.
코루틴도 디스패처가 관리하는 일반 OS 스레드 위에서 실행되다가 중단되면 그 스레드를 반환합니다. 다만 운반자와 달리 어느 스레드 풀에서 실행할지를 개발자가 선택합니다.
| 디스패처 | 기본 스레드 | 용도 |
| Dispatchers.Default | CPU 코어 수 (최소 2) | CPU 연산 위주. 지정하지 않으면 이것이 사용된다 |
| Dispatchers.IO | 64개와 코어 수 중 큰 값 | 블로킹 I/O 전용. 대기가 많으므로 스레드를 넉넉히 배치한다 |
| Dispatchers.Main | 1 (UI 스레드) | Android 등 UI 프레임워크 전용 |
두 다이어그램의 분기 지점
가상 스레드의 ⑦과 코루틴의 ⑤를 나란히 비교하면 차이가 뚜렷합니다.
⑦은 스택을 힙에 저장한 채 잠시 내려놓는 것이고, ⑤는 함수가 실제로 리턴해 스택 프레임 자체가 소멸하는 것입니다.
잔존하는 것은 ③에서 저장한 Continuation 객체 하나뿐이고, 재개(⑨) 역시 이어서 실행하는 것이 아니라 같은 함수를 다시 호출한 후 label로 점프(goto)하는 것입니다.
Continuation은 이 계산이 종료되면 이어서 수행할 일을 담은 객체입니다.
원래 그 정보는 호출 스택 안에 암묵적으로 존재해 접근할 수 없지만, 인자로 전달하면 값이 되므로 힙에 저장해 두었다가 나중에 임의의 스레드에서 꺼내 사용할 수 있습니다.
다음에 할 일을 인자로 전달하는 이 방식을 CPS(Continuation-Passing Style)라 하며, 코루틴이 스택 없이 중단을 구현하는 기반이 됩니다.
2. 표식의 유무 - 투명성과 함수 색칠
중단을 실제로 일으키는 것은 JDK입니다.
소켓 read 같은 블로킹 프리미티브가 지금 가상 스레드 위에서 실행 중임을 감지하면, 커널에 등록해 두고 스스로 중단합니다.
이렇게 중단할 수 있는 것은 스택 전체를 저장하는 구조 때문입니다.
중단 순간의 호출 스택 전체가 함께 저장되므로 중간에 위치한 라이브러리 프레임들은 아무것도 수행하지 않아도 되고, 중단이 일어났다는 사실이 그 프레임에는 드러나지 않습니다.
JDK가 최하단의 블로킹 프리미티브(소켓, 락, sleep 등)를 수정했기 때문에, 그 위의 블로킹 라이브러리는 대부분 수정하지 않아도 확장이 가능해집니다.
코루틴에서는 중단이 호출 체인을 따라 위로 전파되어야 하므로, 체인에 포함된 모든 함수가 suspend로 표시되어야 합니다.
suspend 함수는 suspend 문맥에서만 호출할 수 있으므로 코드가 suspend 세계와 일반 세계로 분리됩니다. 이를 함수 색칠(function coloring)이라 부릅니다.
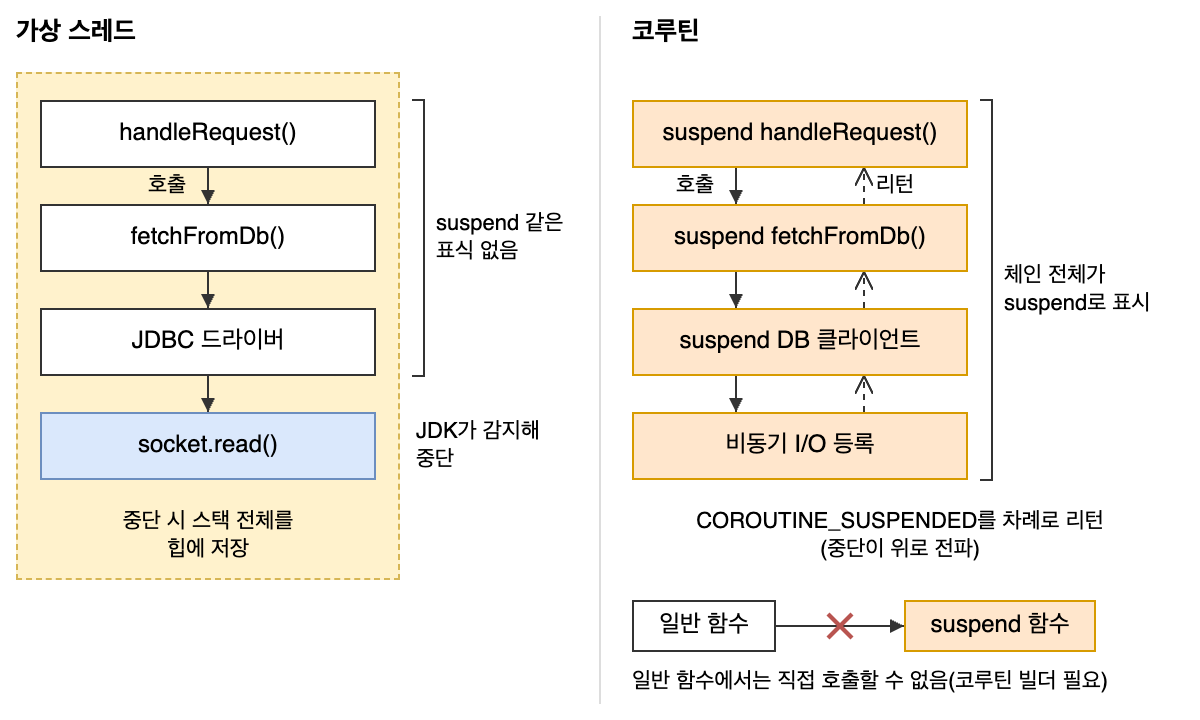
이것이 두 방식의 실질적인 차이이며, 앞서 제시한 명제가 성립하는 지점입니다. 가상 스레드는 중단의 존재를 코드에서 숨기고, 코루틴은 코드에 명시합니다.
어느 쪽이 우월한 것이 아니라 설계 철학의 차이입니다.
다만 숨긴 것은 소멸하지 않습니다. 코드에서 표식을 지운 대가는 다른 자리에서 나타납니다.
3. 숨겨진 대가
(1) 병목의 이동
가상 스레드로 동시 요청 수를 늘려도 DB 커넥션 풀의 크기는 그대로입니다.
HikariCP 풀 크기가 20이라면 가상 스레드가 백만 개여도 동시에 DB를 쓰는 요청은 20개입니다. 처리량을 정하는 것, 즉 병목은 스레드 수가 아니라 이 20입니다.
나머지 요청은 커넥션을 기다립니다.
스레드 풀 모델에서는 이렇게 기다리는 요청의 수에 상한이 있습니다.
대기 큐의 크기를 제한해 두었다면, 큐가 가득 찬 뒤의 요청은 거부됩니다. 클라이언트는 즉시 오류 응답을 받고, 그 순간 오류율이 급증합니다.
가상 스레드에는 스레드 수의 상한이 없습니다.
요청은 거부되지 않고 모두 받아들여져 커넥션을 기다립니다.
오류가 발생하지 않으므로 오류율은 평소 그대로이고, 변하는 것은 응답 시간뿐입니다.
오류는 대기 시간이 타임아웃을 넘기 시작해야 나타나고, 그 시점에는 대기 요청이 이미 많이 누적되어 있습니다.
병목의 위치가 바뀌었습니다.
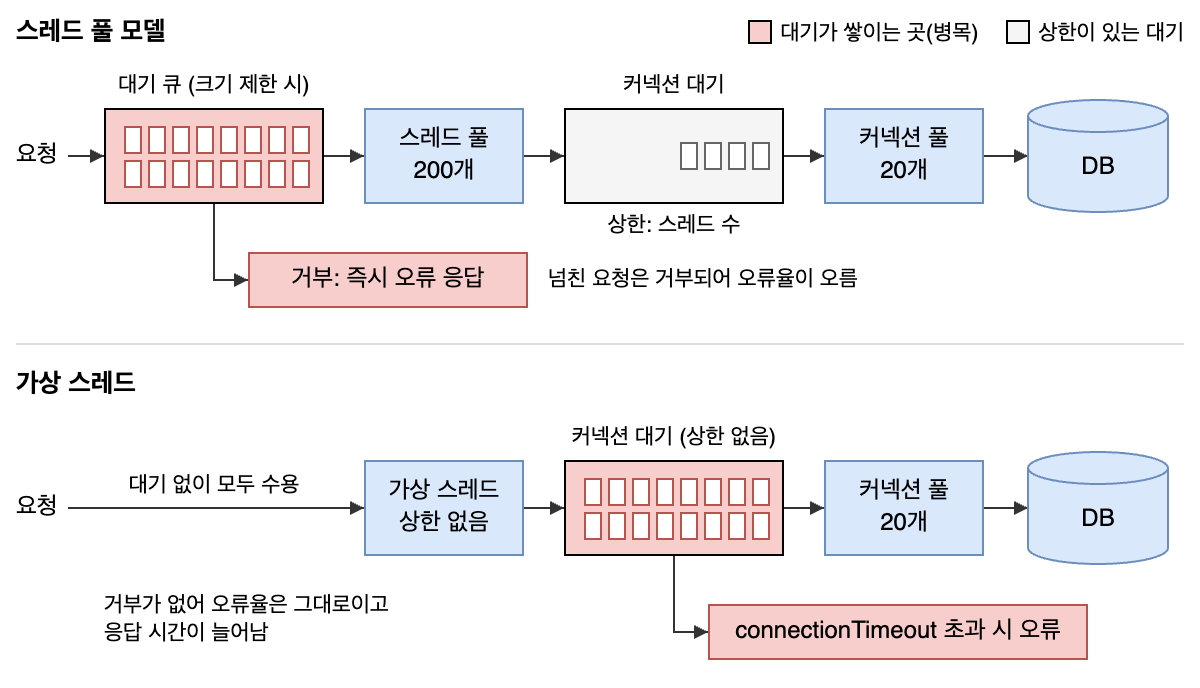
스레드를 얻는 단계에 있던 병목이 커넥션을 얻는 단계로 옮겨간 것이지, 없어진 것이 아닙니다.
사라진 것은 병목이 아니라 오류율에 나타나던 거부입니다.
커넥션 풀은 동시 사용 수를 20으로 제한하는 카운팅 세마포어(counting semaphore)입니다.
요청은 사용 중인 커넥션 하나가 반환될 때까지 대기하게 되고, connectionTimeout은 그 대기 시간의 상한입니다. Semaphore.tryAcquire(timeout)에 대응합니다.
그러므로 타임아웃은 설정값이 작아서 생긴 문제가 아니라 DB가 감당할 수 있는 양을 넘었다는 신호입니다.
풀 크기를 키우면 신호가 사라지는 대신 늘어난 부하가 그대로 DB로 전달됩니다. 이것이 풀 크기만 늘리는 조치가 대부분 잘못된 대응인 이유입니다.
타임아웃은 처리할 수 없는 요청을 일찍 거절하는(load shedding) 근거로 삼고, 풀 크기도 코어 수 × 2 같은 관행이 아니라 DB가 실제로 처리할 수 있는 수치에 맞춰야 합니다.
코루틴에서도 커넥션 풀의 한계는 같습니다. 동시 20개라는 상한이 코드에 드러나지 않는 것도 같습니다.
다만 블로킹 호출은 withContext(Dispatchers.IO)로 감싸야 하므로, DB를 호출하는 지점이 어디인지는 코드에서 찾을 수 있습니다.
(2) ThreadLocal 전제의 변화
ThreadLocal은 값을 스레드마다 따로 보관하는 저장소입니다. 같은 변수를 읽어도 스레드마다 값이 다릅니다.
개발자가 직접 쓰지 않더라도 서버 코드는 이미 ThreadLocal을 쓰고 있습니다.
로깅의 MDC, 스프링 시큐리티의 SecurityContextHolder, 트랜잭션 동기화가 모두 요청별 값을 이 방식으로 보관합니다.
이 방식에는 두 가지 전제가 있습니다.
요청 하나가 스레드 하나를 끝까지 차지한다는 것, 그리고 그 스레드가 여러 요청에 걸쳐 재사용된다는 것입니다.
가상 스레드에서는 이 중 두 번째 전제가 성립하지 않습니다. 스레드가 요청마다 새로 만들어지고 요청이 끝나면 사라지기 때문입니다.
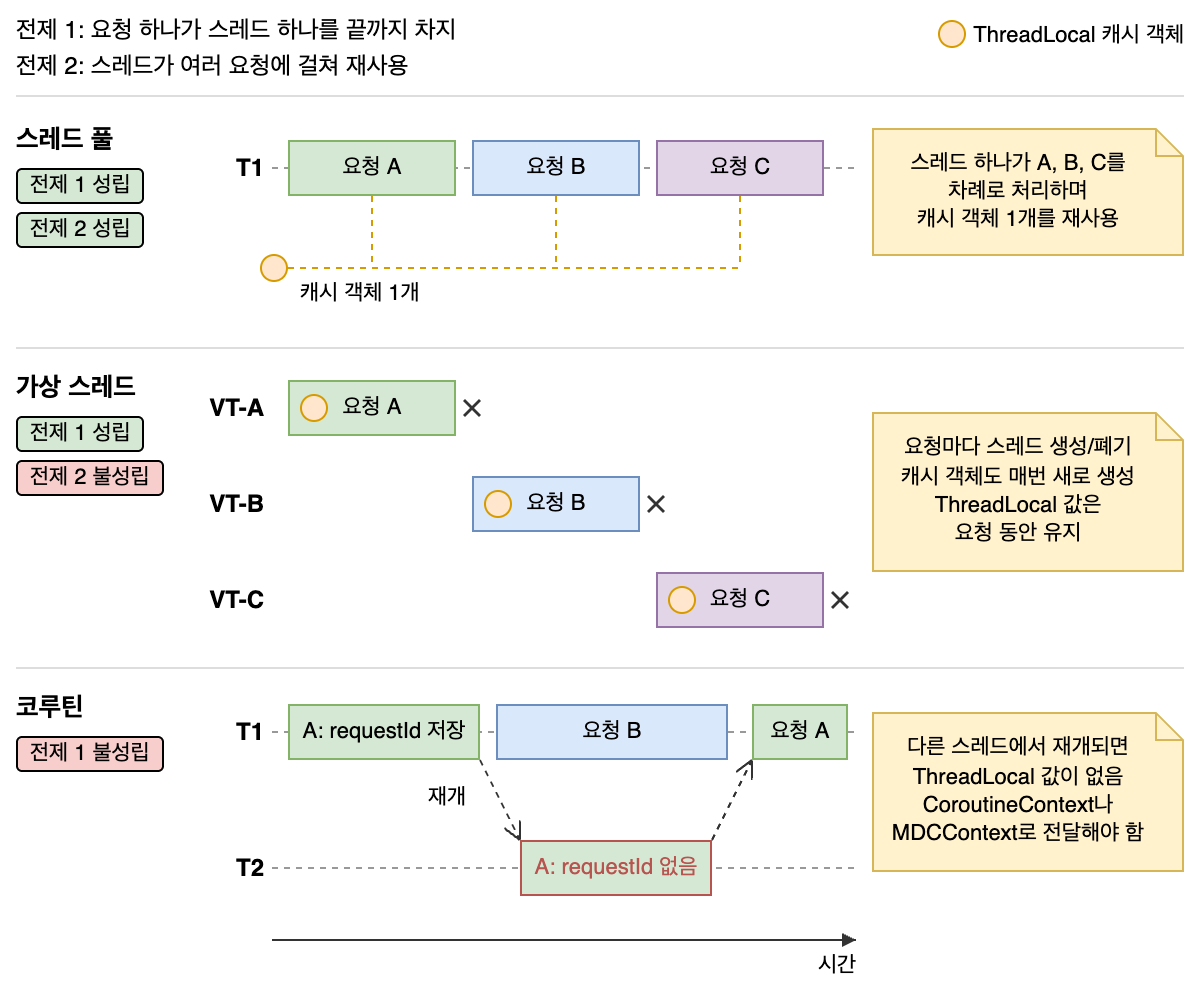
그래서 ThreadLocal의 두 가지 용도 중 하나는 효과를 잃고 하나는 효과가 유지됩니다.
효과를 잃는 것은 ThreadLocal을 캐시 용도로 사용할 때입니다.
비싼 객체를 스레드마다 하나씩 두고 재사용하는 방식이므로, 스레드가 재사용되지 않으면 성립하지 않습니다.
풀 크기가 200이라면 객체는 200개만 생성되고, 그 200개가 요청 100만 건에 걸쳐 재사용되므로 적중률이 사실상 100%입니다.
가상 스레드에서는 같은 100만 건에 객체 100만 개를 만들어 각각 한 번씩만 쓰고 버립니다. 캐시의 이득은 사라지고 생성 비용만 남게 됩니다.
코드는 한 줄도 바뀌지 않고, 늘어난 생성 횟수는 실행 중에만 드러납니다.
효과가 유지되는 것은 ThreadLocal을 컨텍스트 용도로 사용할 때입니다.
다만 이 용도에서는 대가가 메모리에서 발생합니다.
로깅에 쓰는 MDC(Mapped Diagnostic Context)가 대표적입니다.
요청 진입점에서 요청 ID를 MDC.put("requestId", id)로 한 번 넣어 두면, 그 요청을 처리하는 동안 기록되는 모든 로그에 그 요청 ID가 함께 출력됩니다. 중간 함수들은 요청 ID를 인자로 받지 않습니다.
이 용도로 사용할 때 필요한 것은 첫 번째 전제뿐입니다. 요청이 끝날 때까지 스레드 하나가 그 요청만 처리하면, 스레드로 값을 찾는 것이 곧 그 요청의 값을 찾는 것이 됩니다.
요청이 끝난 뒤 그 스레드가 사라지는지 다음 요청에 다시 쓰이는지는 이 용도에 영향을 주지 않습니다.
풀 스레드에서는 MDC.clear()를 누락하면 앞 요청의 값이 다음 요청의 로그에 섞입니다.
가상 스레드는 요청이 끝나면 소멸하므로 지울 것이 남지 않고, 그런 누출도 일어나지 않습니다.
코드를 수정하지 않았는데 MDC는 더 정확해집니다.
대신 가상 스레드 수만큼 맵이 생성되고 InheritableThreadLocal이면 부모 값까지 복사되므로, 스레드가 많아질수록 메모리 사용량이 늘어납니다.
이것도 코드에는 나타나지 않고 힙에만 나타납니다.
그래서 등장한 대안이 ScopedValue입니다.
스코프를 벗어나면 소멸하므로 지울 것이 남지 않고, 자식에게 복사 없이 공유되므로 맵이 늘어나지도 않습니다. 정식으로 사용할 수 있는 것은 JDK 25부터입니다.
| 용도 | 스레드 풀 | 가상 스레드 |
| 캐시(스레드마다 비싼 객체 재사용) | 유효(객체 200개를 요청 100만 건에 재사용) | 효과 상실(요청마다 새로 생성) |
| 컨텍스트(MDC 등 요청별 값) | 유효(MDC.clear() 누락 시 다음 요청에 누출) | 유효(누출 없음, 스레드 수만큼 메모리 증가) |
| 성립하는 전제 | 전제 1, 2 | 전제 1 |
코루틴은 중단 지점마다 다른 스레드에서 재개될 수 있습니다. 가상 스레드에서 유지되던 첫 번째 전제가 여기서는 성립하지 않습니다.
ThreadLocal에 담은 값은 중단 이후까지 유지되지 않습니다.
그래서 요청별 값은 CoroutineContext에 담거나, MDC를 쓰려면 MDCContext 같은 요소를 명시적으로 붙여야 합니다.
가상 스레드에서는 코드의 변경이 없어도 동작하고 대가는 실행 중에만 나타납니다. 하지만 코루틴에서는 코드를 수정해야 합니다. 수정하지 않으면 중단 이후의 로그에서 요청 ID가 사라집니다.
(3) 중단이 성립하지 않는 경우
두 방식 모두 하위 계층이 중단을 지원하지 않으면 중단이 성립하지 않습니다.
가상 스레드에서는 JNI 네이티브 코드를 호출하거나 예전 Java 버전(JDK 24 이전)에서 synchronized 블록 안에서 블로킹할 때 중단이 성립하지 않습니다. 그 순간 가상 스레드는 운반자 스레드를 반환하지 못합니다(pinning).
그 구간에서는 사실상 예전 스레드 풀 모델과 같아집니다.
운반자는 코어 수만큼밖에 없으므로 하나만 반환되지 않아도 전체 처리 능력이 그만큼 줄어듭니다. 스케줄러는 반환되지 않은 운반자를 대신할 스레드를 자동으로 보충하지 않습니다.
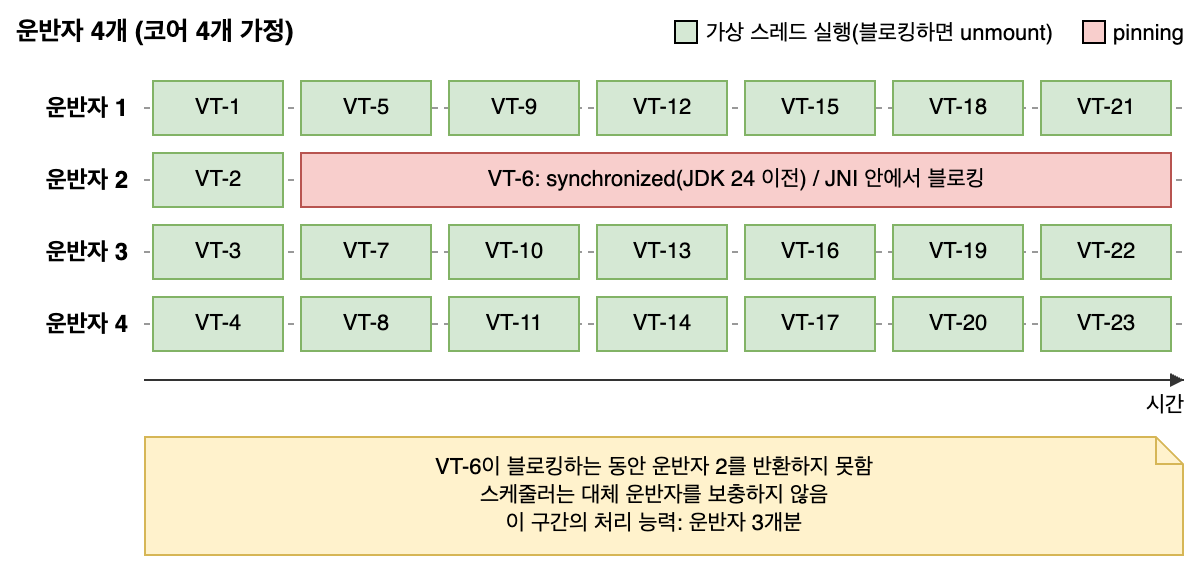
코루틴에서는 코루틴 안에서 블로킹 호출(일반 JDBC, Thread.sleep() 등)을 하면 중단이 성립되지 않습니다. 컴파일러는 suspend 함수만 변환하므로, 그 아래의 실제 스레드가 그대로 막힙니다.
스레드를 실제로 반환하려면 I/O 스택 전체가 suspend 기반이어야 합니다. 불가피하게 블로킹 호출을 사용해야 한다면 withContext(Dispatchers.IO)로 옮겨 블로킹 전용 스레드에서 실행해야 합니다.
두 문제가 드러나는 위치가 다릅니다.
코루틴 쪽은 블로킹 호출이 코드에 그대로 남아 있어서 작성하거나 리뷰하는 단계에서 발견할 수 있습니다.
가상 스레드 쪽은 pinning이 발생하는 코드도 컴파일되고 기능 테스트도 통과합니다. 그래서 부하가 걸린 뒤 처리량이 기대에 못 미치는 것을 확인하고서야 원인을 추적하게 됩니다.
synchronized로 인한 pinning은 JDK 24에서 해소되었으므로, 버전을 올리면 그 원인은 사라집니다.
JNI로 인한 pinning은 버전과 무관하게 남으므로 실행 중에 확인해야 합니다.
추가로 pinning이 남는 케이스는 JNI 외에도 몇 가지 케이스가 있으니 확인해 보시기 바랍니다.
4. 측정과 판단
두 방식의 대조
| Virtual Thread | Kotlin Coroutine | |
| 분류 | Stackful (런타임이 처리) | Stackless (컴파일러가 변환) |
| 중단 표식 | 없음 (투명) | suspend (명시적) |
| 함수 색칠 | 없음 | 있음 |
| 중단 가능 위치 | 호출 스택 어디서든 | 표시된 지점에서만 |
| 중단 시 저장 대상 | 실제 스택 전체 | Continuation 객체 |
| 재개 방식 | 스택 복원 후 이어서 실행 | 함수 재호출 + label 점프 |
| 기존 블로킹 코드 | 수정 없이 그대로 확장 | suspend 기반 재작성 필요 |
| 취소 | Thread.interrupt() | CancellationException (일급) |
| 범위 | 스레드 추상화 | Flow · Channel · 멀티플랫폼까지 |
| 등장 | Java 21 (2023) | Kotlin 1.3에서 안정화 (2018) |
양자택일 관계만은 아닙니다. 코루틴 디스패처를 가상 스레드 위에서 실행할 수도 있습니다.
val dispatcher = Executors.newVirtualThreadPerTaskExecutor().asCoroutineDispatcher()모니터링 대상
JFR(Java Flight Recorder) 이벤트 두 가지를 확인합니다.
jdk.VirtualThreadPinned는 잔존하는 pinning을, jdk.VirtualThreadSubmitFailed는 가상 스레드의 시작/재개 요청이 스케줄러에 제출되지 못한 경우(자원 부족 등)를 기록합니다.
버전 선택
| 버전 | 시점 | 이 주제와 관련된 내용 |
| Java 21 (LTS) | 2023-09 | 가상 스레드 정식. synchronized pinning 있음 |
| Java 24 | 2025-03 | JEP 491 — synchronized pinning 해소 |
| Java 25 (LTS) | 2025-09 | 현재 LTS. 구조적 동시성 API 개편(프리뷰) |
| Java 26 | 2026-03 | JEP 525 - 구조적 동시성 여섯 번째 프리뷰(API 소폭 변경) |
| Java 27 | 2026-09 | 최신 릴리스. 구조적 동시성 일곱 번째 프리뷰 |
가상 스레드를 본격적으로 사용할 계획이라면 JDK 21 LTS보다 JDK 25 LTS가 유리합니다. pinning 문제가 해소된 첫 LTS이기 때문입니다.
구조적 동시성(StructuredTaskScope)은 JDK 27 시점에도 여전히 프리뷰이므로 운영 코드에 투입하기에는 이릅니다.
선택 기준
JVM에서 순수하게 I/O 동시성이 목적이라면 이제 가상 스레드로 충분한 경우가 많습니다. 기존 블로킹 코드를 그대로 사용할 수 있다는 이점이 큽니다.
반면 Flow 같은 비동기 스트림 표현력, Channel 기반 설계, 세밀한 취소 제어, Kotlin 멀티플랫폼이 필요하다면 코루틴이 여전히 적합합니다.
이미 코루틴으로 작성된 코드를 가상 스레드로 전환할 이유는 없습니다.
다만 어느 쪽을 선택하든 이 글의 결론은 동일하게 적용됩니다.
두 방식 모두 대기 비용을 낮출 뿐 자원의 총량을 늘리지 않습니다.
가상 스레드는 그 사실을 코드에서 숨기고 코루틴은 드러낼 뿐입니다.
그래서 도입을 검토하는 단계에서는 대기의 대상인 자원(커넥션 풀, 외부 API 쿼터, 디스크)을 먼저 측정해야 합니다.
참고
- JEP 491: Synchronize Virtual Threads without Pinning
- JEP 505: Structured Concurrency (Fifth Preview)
- Virtual Threads After JDK 24: What Changed for Production Java (InfoQ)
- Virtual Threads After JEP 491: The Bottleneck Moved
- Java 24 - Thread pinning revisited
- JEP 444: Virtual Threads
- Virtual Threads — Oracle Java 21 Core Libraries Guide
- JEP 506: Scoped Values
- Scoped Values: A Better Alternative to ThreadLocal for Virtual Threads
- ThreadLocal vs. Scoped Values: The Virtual Thread Migration No One Warned You About